Une business intelligence stack fiable repose sur 7 couches, des sources aux KPI
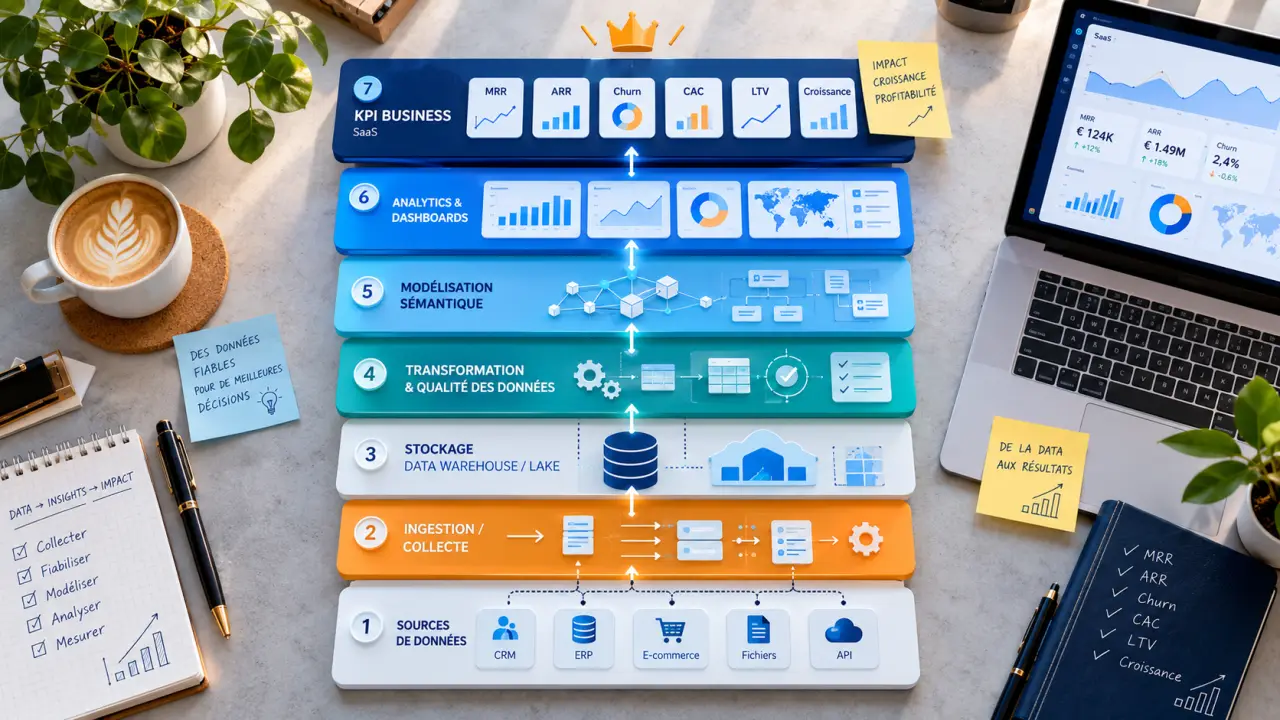
Une business intelligence stack regroupe les technologies, les règles et les pratiques qui font circuler les données des outils opérationnels jusqu’aux tableaux de bord. Son objectif est de produire des indicateurs fiables, compréhensibles et cohérents, utilisables par les équipes commerciales, financières ou produit.
Une business intelligence stack, de la donnée brute à la décision
La BI ne se limite pas à la data visualisation. La visualisation est la dernière étape, celle qui rend l’information lisible. La business intelligence couvre aussi la collecte, la préparation, la modélisation, la gouvernance et la diffusion des données. L’analytics va souvent plus loin avec l’exploration, la recherche de causes, les prévisions ou les analyses ad hoc.
Quiz : La Stack Business Intelligence
Une stack BI répond à un problème concret : une entreprise possède des données réparties entre CRM, ERP, plateforme e-commerce, application métier, outils marketing, fichiers Excel, bases de données et API SaaS. Sans chaîne commune, chaque équipe reconstruit ses calculs. Le chiffre d’affaires, le nombre de clients actifs ou le taux de conversion peuvent alors varier d’un fichier à l’autre.
Le flux à connaître en 7 couches
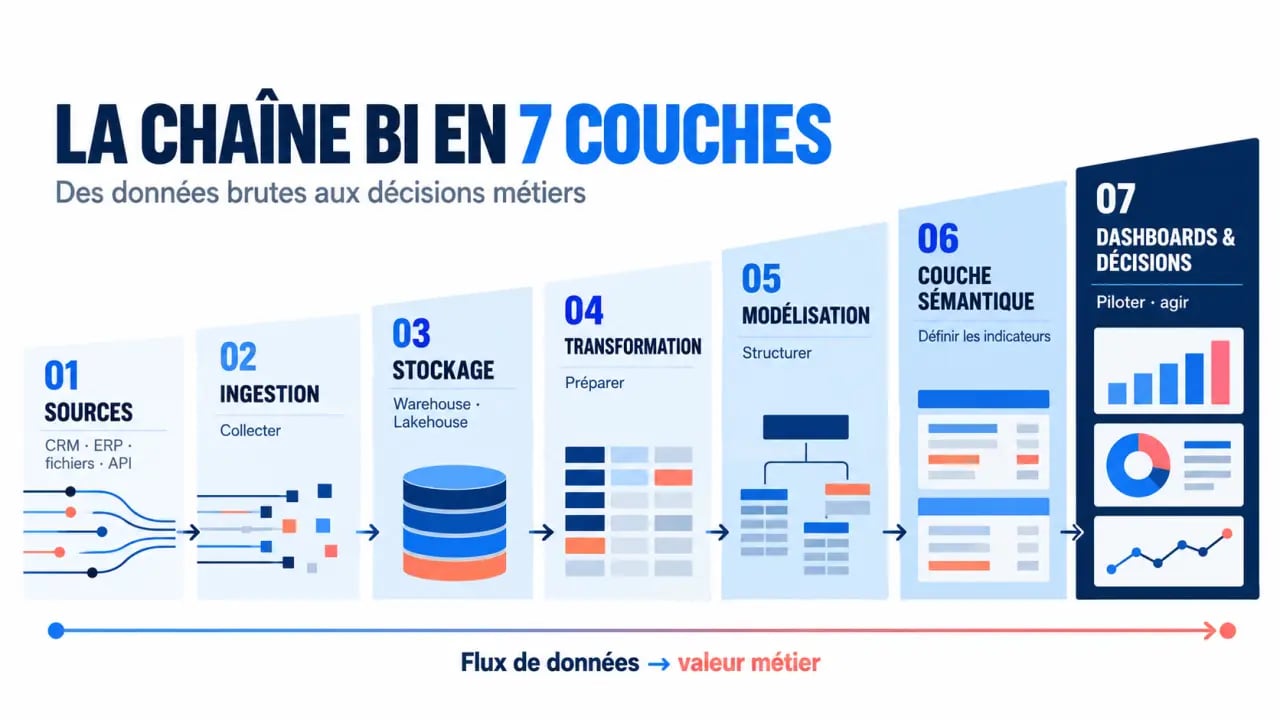
Une architecture moderne peut se lire comme un parcours en 7 couches : sources, ingestion, stockage, transformation, modélisation, couche sémantique, puis visualisation et consommation. Les données d’un CRM, d’un ERP, d’événements applicatifs ou de fichiers alimentent des pipelines. Elles sont centralisées dans un entrepôt ou un lakehouse, nettoyées, enrichies, puis proposées aux utilisateurs sous forme de rapports, de dashboards, d’analyses à la demande ou d’analytics embarqué dans une application.
- Sources : bases relationnelles, API, CRM, ERP, fichiers CSV ou Excel, événements web et applicatifs.
- Ingestion : réplication, extraction et chargement des données.
- Stockage : data warehouse ou lakehouse analytique.
- Transformation : calculs, nettoyage, jointures et tests de qualité.
- Modélisation : faits, dimensions, hiérarchies et tables métier.
- Couche sémantique : métriques, règles de calcul et droits d’accès partagés.
- Consommation : reporting, tableaux de bord, exploration et activation opérationnelle.
Les couches qui déterminent vraiment la fiabilité des tableaux de bord
Ingestion, ETL et ELT : faire entrer les données sans perdre leur trace
L’ingestion relie les systèmes sources à la plateforme analytique. Des solutions comme Fivetran, Airbyte, Stitch, Meltano, dlt, Talend ou SSIS peuvent automatiser cette étape. L’ETL extrait, transforme puis charge les données. L’ELT les extrait, les charge d’abord dans le stockage analytique, puis les transforme sur place. Cette seconde approche s’intègre bien aux entrepôts cloud capables d’exécuter des traitements SQL à grande échelle.
Le choix ne dépend pas uniquement des connecteurs disponibles. Il faut aussi définir la fréquence de synchronisation, la gestion des suppressions, la reprise après incident, la conservation des données historiques et la traçabilité. Un dashboard rapide, mais alimenté par une donnée incomplète, reste un mauvais outil de pilotage.
Warehouse, lakehouse et modèle dimensionnel
Un data warehouse convient particulièrement aux données structurées et au reporting gouverné. Snowflake, BigQuery, Redshift ou SQL Server sont couramment utilisés dans ce rôle. Un lakehouse, tel que Databricks, associe des usages d’entrepôt à des capacités adaptées à des données plus variées et à certains traitements avancés. Il devient pertinent lorsque l’organisation combine BI, données non structurées, événements volumineux ou traitements Spark.
Après le stockage, la modélisation donne une forme exploitable aux données. Le modèle dimensionnel sépare généralement les faits, comme les ventes, les commandes et les visites, des dimensions, comme la date, le client, le produit et la région. Cette organisation facilite le filtrage, le slicing and dicing et la lecture des KPI. dbt, Dataform, SQLMesh ou Spark peuvent servir à industrialiser les transformations, les tests et la documentation.
La couche sémantique, point de passage entre technique et métier
La couche sémantique traduit les tables techniques en concepts métier. Elle définit, par exemple, ce qu’est un « client actif », le périmètre d’une « marge » ou le calcul d’un « revenu récurrent ». Elle peut aussi appliquer des politiques d’accès et améliorer les performances grâce au cache. LookML dans Looker, les mesures DAX dans Power BI ou un modèle centralisé remplissent cette fonction.
Pour évaluer cette couche, il faut pouvoir suivre le trajet inverse d’un KPI : du chiffre affiché vers sa formule, les tables transformées, les données brutes et enfin le système qui les a produites. Si ce chemin est impossible à expliquer à un utilisateur métier, l’indicateur n’est pas réellement gouverné. Cette traçabilité, appelée lineage, évite que la confiance repose sur la seule apparence du dashboard.
Stack Microsoft traditionnelle ou architecture composable ?
Une stack Microsoft BI classique s’appuie historiquement sur SQL Server pour le stockage, SSIS pour l’intégration, SSAS pour les cubes OLAP ou les modèles tabulaires, et SSRS pour le reporting. Excel, SharePoint BI dashboards, Power View et d’autres composants ont complété cet écosystème. Cette approche centralisée est pertinente lorsqu’une organisation est déjà fortement équipée Microsoft, recherche une administration homogène et veut standardiser ses usages autour de Power BI.
Maîtriser la modélisation des données dans Power BI — Apprenez à transformer vos données, créer des relations, écrire du DAX et optimiser vos modèles sémantiques Power BI.
Une architecture composable, ou best-of-breed, associe des outils spécialisés : Airbyte pour l’ingestion, BigQuery ou Snowflake pour le warehouse, dbt pour la transformation et Looker, Tableau, Metabase ou Superset pour l’exposition. Chaque composant peut évoluer indépendamment. En contrepartie, l’équipe doit intégrer les outils, gérer les identités, surveiller les coûts et maintenir les pipelines.
| Approche | Atout principal | Point de vigilance | Contexte adapté |
|---|---|---|---|
| Plateforme intégrée | Administration et expérience plus unifiées | Dépendance plus forte à un éditeur | Organisation standardisée, notamment dans l’écosystème Microsoft |
| Stack composable | Souplesse et interchangeabilité des briques | Complexité d’intégration et d’exploitation | Équipe data disposant de compétences techniques |
| Lakehouse | Usages analytiques et données variées dans un même socle | Architecture à cadrer pour rester accessible aux métiers | Volumes, événements ou besoins data avancés |
Choisir les outils BI selon les utilisateurs et les usages
Le meilleur outil dépend du cas d’usage. Power BI convient souvent aux organisations proches de Microsoft et à un self-service encadré. Tableau est apprécié pour l’exploration visuelle. Looker place la gouvernance et la modélisation au centre de l’expérience. Metabase et Superset peuvent répondre à des besoins de déploiement plus légers ou à des préférences open source. Looker Studio convient à certains besoins de reporting connectés à l’écosystème Google.
La comparaison doit porter sur l’ensemble du parcours, pas uniquement sur la galerie de graphiques.
- Utilisateurs : analystes SQL, équipes métier autonomes, direction ou clients externes.
- Gouvernance : métriques certifiées, droits par ligne, catalogue, documentation et validation des rapports.
- Fraîcheur : rafraîchissement quotidien, intra-journalier ou quasi temps réel selon la décision à prendre.
- Diffusion : consultation à la demande, envoi par e-mail, export ou intégration dans une application.
- Exploitation : alertes sur les échecs de pipeline, tests, monitoring, coûts d’infrastructure et maintenance.
Les rôles doivent aussi être clarifiés. Le data engineer fiabilise les flux, l’analytics engineer structure les modèles métier, le data analyst produit et explique les analyses, tandis que les responsables métier valident les définitions et utilisent les résultats. Sans cette répartition, le self-service peut créer une prolifération de rapports contradictoires.
Construire, acheter ou faire évoluer sa business intelligence stack
L’approche buy privilégie le délai de mise en valeur : connecteurs, interfaces, mises à jour et fonctionnalités sont fournis par l’éditeur. Elle convient lorsque l’objectif est de livrer rapidement des cas d’usage récurrents sans bâtir une équipe d’ingénierie importante. Le build apporte davantage de contrôle sur les modèles, l’intégration applicative, les règles métier et l’expérience analytique embarquée, mais exige des compétences durables pour concevoir, tester et opérer la solution.
Le bon arbitrage est rarement totalement binaire. Une entreprise peut acheter l’ingestion et la visualisation, tout en construisant ses modèles dbt et sa couche de métriques. Elle peut aussi démarrer avec un warehouse et un nombre limité de dashboards, puis ajouter une CDP ou du reverse ETL lorsque les segments validés doivent être activés dans les outils marketing ou commerciaux.
- Partir de trois à cinq décisions métiers prioritaires, plutôt que d’une liste d’outils.
- Recenser les sources, leurs propriétaires, leur qualité et la fraîcheur nécessaire.
- Définir les métriques communes avant de multiplier les tableaux de bord.
- Choisir une architecture proportionnée aux compétences internes et au budget d’exploitation.
- Prévoir dès le départ les accès, la documentation, les tests et le suivi des incidents.
Une business intelligence stack réussie n’est pas celle qui additionne le plus de technologies. C’est celle qui rend les indicateurs fiables, leur origine vérifiable et leur usage assez simple pour que les équipes transforment l’analyse en action.